casos CASE / 001
Resolvendo um gargalo de execução
16 MINUTES → < 47 SECONDS
De 16 minutos para 47 segundos: Redução de tempo de execução sem reescrever o sistema.
O problema
Ao analisar a saúde dos processos executados nos produtos que tratamos, utilizei um mapa de priorização — tema que pretendo abordar em outra postagem — para identificar os principais casos de uso do sistema. Em um deles, verifiquei que uma carga de base levava aproximadamente 16 minutos para ser executada.
Ao questionar a equipe, recebi a explicação que já havia se tornado quase uma premissa: o processo sempre havia levado aproximadamente esse tempo porque a base possuía cerca de 90 mil produtos. Em vez de assumir essa explicação como causa, optei por separar algumas horas para investigar se havia espaço para melhoria.
Havia.
A primeira reação diante de um problema assim costuma ser procurar o trecho de código “lento”. Mas havia uma pergunta anterior que precisava ser respondida: o código realmente estava lento ou o problema era resultado de alguma coisa acontecendo ao redor dele?
Foi aí que a investigação começou.
01 — Dados primeiro
A primeira decisão foi natural: não alterar código até entender o que estava acontecendo. Em sistemas legados, existe uma tentação muito grande de jogar todo crime na conta do código e cair na síndrome que todo programador sente mais cedo ou mais tarde: tem que refatorar.
Isso pode funcionar? Sim, mas também pode esconder o problema real.
Antes de alterar qualquer coisa, eu precisava separar três possibilidades:
- A lógica é realmente custosa?
- A culpa é do ambiente / infraestrutura?
- Como está a interação com JVM/runtime?
Primeiro utilizei um script Python que percorria todo o log do processo e me trazia a quantidade de tempo que cada método do processo levava para ser executado. As saídas de log eram algo semelhante a:
[Nível de log] data HH:MM:SS:SSS [THREAD] Classe :: Método :: textoCom essas informações em mãos, consegui criar um ranking dos métodos que levavam mais tempo de execução e os coloquei no topo da lista — seriam verificados primeiro. O próximo passo foi utilizar o Java Flight Recorder (JFR) como ferramenta de investigação.
02 — Medir antes de concluir
Segundo a própria Oracle:
Java Flight Recorder (JFR) é uma ferramenta para coletar dados de diagnóstico e criação de perfil sobre um aplicativo Java em execução. Ele é integrado à Máquina Virtual Java (JVM) e quase não causa sobrecarga de desempenho, por isso pode ser usado mesmo em ambientes de produção muito carregados.
Em resumo, o JFR é um raio-x da JVM. Ele permite pular perguntas como “por que esse método parece lento?” e ir direto para: “O que a JVM estava fazendo durante a execução desse método?”. Isso muda completamente a investigação. Usei o JFR para capturar a execução e analisei os dados no Java Mission Control.
JDK Mission Control (JMC) é um conjunto avançado de ferramentas para gerenciamento, monitoramento, criação de perfil e solução de problemas de aplicações Java. O JMC permite uma análise de dados eficiente e detalhada para áreas como desempenho de código, memória e latência, sem introduzir a sobrecarga de desempenho normalmente associada a ferramentas de criação de perfil e monitoramento.
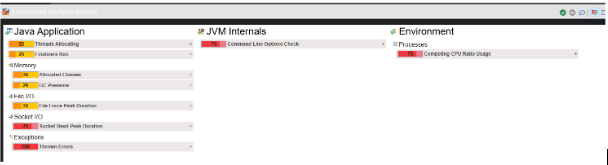
Basicamente o JMC lê o arquivo JFR e traz insights e dashboards que permitem ter uma visão mais holística do que estava acontecendo na JVM. A intenção não era procurar uma linha mágica dizendo:
ERROR: PERFORMANCE BADEra construir uma visão do comportamento do processo. CPU, Garbage Collection, Threads, Sockets, Chamadas nativas, Tempo de execução, Eventos da JVM…
A investigação começou a revelar que não havia um único gargalo. Havia vários fatores contribuindo para o tempo total. E havia uma surpresa: o código estava entre os menores deles.
03 — O primeiro sinal
Ao medir os métodos envolvidos no processo, encontrei uma diferença importante. Um dos métodos que participava da execução — e que era bem simples — apresentava uma duração média de aproximadamente 44 segundos. Isolando o mesmo trecho de código em outro ambiente, esse mesmo método passou a executar em menos de 1 segundo. Essa diferença foi importante porque mostrou que o problema não era simplesmente “o processo inteiro está demorando 16 minutos”. Existiam pontos específicos onde o tempo estava sendo perdido.
A pergunta então passou a ser:
por que um método que não havia mudado sua regra de negócio estava demorando tanto de um ambiente para o outro?
04 — JDWP
Um dos fatores encontrados durante a investigação foi o JDWP habilitado. O mecanismo é utilizado para permitir recursos de debugging da JVM e pode introduzir overhead durante a execução. O ponto da investigação, porém, não era determinar se “JDWP é ruim”. A pergunta era: por que um mecanismo de debugging estava participando daquela execução?
A diferença pode parecer pequena, mas esse tipo de pergunta é importante na investigação de performance. Quando tratamos da melhoria de performance de software, não podemos apenas sair cortando coisas ou as alterando sem entender o motivo principal de por que elas estavam ali para começo de conversa e, principalmente, entender qual impacto a mudança desejada terá — além da performance.
05 — Heap e Garbage Collection
Outro ponto encontrado foi relacionado ao dimensionamento do heap. A aplicação estava sofrendo com pressão de Garbage Collection. Isso trouxe outra distinção importante. Quando um método demora, é muito fácil olhar apenas para o método. Mas a JVM também precisa administrar a memória enquanto esse método é executado. Sob pressão de memória, a JVM pode precisar executar ciclos do Garbage Collection com maior frequência ou duração, consumindo CPU e aumentando pausas ou latências percebidas pela aplicação.
Em outras palavras:
Tempo observado pelo método ≠ Tempo gasto exclusivamente na lógica do método
O tempo que o usuário percebe é consequência de todo o sistema.
06 — Sockets e CPU
Encontrei também latência em operações de socket e competição por CPU. Isso foi importante porque reforçou uma hipótese que apareceu desde o início: eu não estava diante de um único problema de código. A aplicação estava sendo afetada por uma combinação de fatores.
Uma execução pode ser representada de maneira simplificada assim:
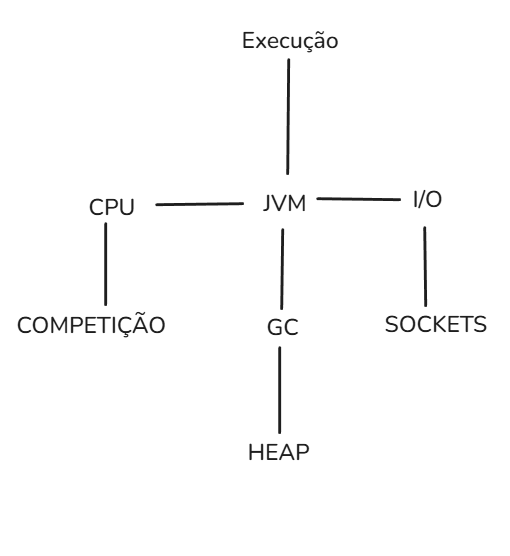
Cada componente isoladamente pode parecer pequeno, mas o problema aparece quando todos eles participam da mesma execução.
07 — E então apareceu o elefante na sala
A parte mais interessante da investigação apareceu quando cheguei às chamadas nativas. A aplicação dependia de uma DLL proprietária da própria empresa e, no ambiente sob investigação, havia um desalinhamento claro de arquitetura: DLL 32-bit e JVM 64-bit.
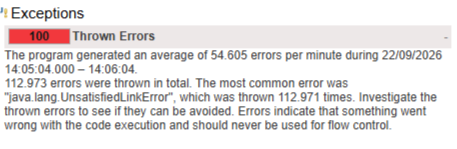
Aqui o sintoma clássico existe — e o JFR deixou isso explícito: no intervalo analisado foram lançados da ordem de 112 mil erros, quase todos java.lang.UnsatisfiedLinkError (cerca de 54 mil erros por minuto).
O ponto controverso é que a aplicação continuava executando o fluxo. Não havia, no acompanhamento operacional do dia a dia, uma falha funcional óbvia do tipo “o processo parou”. O que havia era uma chuva de exceções nativas sendo lançada durante a execução — o tipo de coisa que destrói performance quando vira caminho normal, não incidente isolado.
Em outras palavras: o problema não se apresentou só como “método X lento”. Se apresentou como runtime pagando o preço de tentar (e falhar) o link nativo em loop, enquanto a carga de base seguia em frente.
Esse tipo de problema é particularmente desagradável porque nem sempre aparece onde esperamos. Não necessariamente existe uma exceção clara no log da aplicação dizendo:
“Olá, sou uma DLL incompatível e estou prejudicando sua performance.”
No meu caso, o acompanhamento operacional não apontava fumaça funcional óbvia; a aplicação continuava funcionando. Foi justamente por isso que a investigação baseada apenas em logs de negócio ou apenas em código não teria sido suficiente.
O perfil de execução não entregou a solução pronta. Ele me mostrou onde procurar.
08 — O mais importante: não reescrevi o sistema
Depois de identificar os fatores envolvidos, uma coisa ficou clara: não era necessário reescrever nenhuma funcionalidade. Não mudei as regras de negócio. Não troquei as bibliotecas responsáveis pela funcionalidade. Não transformei um processo legado em uma arquitetura completamente diferente. As correções foram direcionadas aos problemas encontrados no ambiente/runtime.
Isso é uma distinção importante em manutenção de sistemas corporativos. Às vezes, quando encontramos uma aplicação antiga e lenta, a primeira vontade é:
“Precisamos refatorar tudo. A culpa é do código legado!”
Mas performance engineering exige outra pergunta:
“Qual é o menor conjunto de mudanças capaz de eliminar o problema que conseguimos medir?”
Nesse caso, essa abordagem foi suficiente.
09 — O resultado
Depois das correções, o processo que levava aproximadamente:
16 MINUTOS passou a executar em 47 segundos
E um dos métodos que apresentava aproximadamente:
44s de média passou para menos de 1s — assim como no ambiente isolado.
Sem alteração das regras de negócio. Sem substituição das bibliotecas. Sem reescrever o processo.
10 — O que eu aprendi
O principal aprendizado desse caso não foi sobre Java. Também não foi sobre JFR. Foi sobre investigação. Quando uma aplicação está lenta, existe uma diferença enorme entre: “eu acho que esse código está lento” e: “eu medi a execução e sei onde o tempo está sendo gasto.”
A segunda afirmação é muito mais útil. Performance não começa com otimização; começa com observabilidade. Antes de alterar código, precisamos saber:
- onde o tempo está sendo gasto;
- quanto tempo está sendo gasto;
- qual parte pertence à aplicação;
- qual parte pertence à JVM;
- qual parte pertence ao ambiente;
- quais eventos acontecem durante a execução;
- quais mudanças realmente alteram o resultado.
Nesse caso, o processo de melhoria acabou servindo também como oportunidade para olhar mais profundamente para o comportamento da aplicação e aprender ainda mais sobre o seu funcionamento a níveis mais basilares. O código não precisava necessariamente ser reinventado. Eu precisava entender o que estava acontecendo ao redor dele.
11 — Replicando
Abaixo, um resumo de como replicar a metodologia usada neste case:
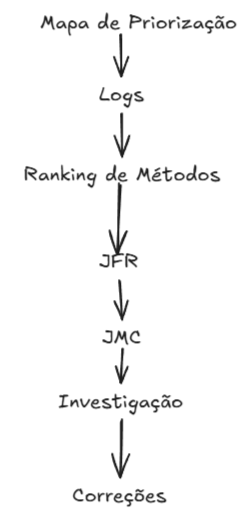
- Tenha em mãos um mapa de priorização dos casos de uso; ele vai te dizer quais casos de uso têm maior valor agregado para o cliente e evita que você gaste energia e tempo em coisas que têm valor muito baixo para o cliente.
- Grave logs de execução do caso de uso a ser analisado — se possível em mais de um ambiente — e depois crie uma tabela com classe/método e tempo de execução. Novamente, isso vai ser o seu guia: comece principalmente pelos de maior tempo de execução. Reduzir 10% de 1 minuto significa uma redução de 6 segundos; 50% de 6 segundos são 3.
- Com a aplicação rodando — sim, existem outros métodos, mas esse é o mais simples — encontre o PID e execute:
jcmd <PID> JFR.start filename=<nome-do-arquivo>.jfr duration=<duração-em-segundos>s- Replique o caso de uso que deseja gravar durante o tempo que configurou na linha de comando.
- Abra o arquivo
.jfrque você gravou; o JMC já de cara te mostrará alguns problemas de execução.